Foto: Steve Jurvetson · CC BY 4.0 · Wikimedia Commons
Del 28 al 30 de septiembre de 2026, parte del equipo de Myukura trabajó en Barcelona en el 8.º MareNostrum Hackathon (MNHACK26), organizado por el Barcelona Supercomputing Center junto con NVIDIA, dentro de Open Hackathons y con Do IT Now como patrocinador. Conocimos la convocatoria a través de NVIDIA Inception, el programa del que formamos parte, y fuimos seleccionados con una propuesta centrada en el reconocimiento automático de voz clínica en español.
Por qué la voz clínica es un problema distinto
En condiciones controladas, convertir voz en texto parece una tecnología casi resuelta. Pero una consulta no es una grabación preparada para un benchmark: hay interrupciones, distancias distintas al micrófono, habla rápida, nombres propios, medicamentos, cantidades, dosis, siglas y formas de hablar que cambian entre regiones y personas.
Además, no todos los errores pesan igual. Equivocarse en una palabra cotidiana no es lo mismo que hacerlo en información clínicamente relevante. Por eso no nos basta una cifra global: nos interesa qué se equivoca, cuándo y qué tipo de información cuesta más reconocer.
Español, terminología y acentos
Buena parte de los datasets de voz y de los modelos más utilizados se han desarrollado con una fuerte presencia del inglés. El español plantea retos propios, y dentro del español hay una variabilidad enorme entre países, regiones y hablantes.
Para una empresa nacida en Andalucía, reconocer distintos acentos no es una cuestión académica: es el entorno real en el que esperamos que la tecnología se utilice. A ello se suma el vocabulario clínico, con fármacos, principios activos, unidades, dosis y términos poco frecuentes en una conversación general.
Qué hicimos durante el hackathon
El formato no era competitivo. Cada equipo podía usar infraestructura de computación de alto rendimiento, trabajar sobre su propio problema y recibir acompañamiento técnico de mentores. Durante las jornadas entrenamos y evaluamos nuestros propios modelos, probamos distintas configuraciones y analizamos los resultados para entender cómo respondían a nuestro caso de uso.
Disponer de GPU de alto rendimiento aceleró parte del trabajo experimental y permitió hacer comparaciones difíciles con recursos más limitados. Pero lo más valioso no fue la potencia de cálculo en sí, sino poder usarla para formular mejores preguntas.
Medir antes de integrar
En productos de inteligencia artificial es frecuente encontrar un modelo con buenos resultados públicos y empezar a construir encima de inmediato. Nuestra experiencia va en sentido contrario: antes de integrar un modelo en una arquitectura clínica hay que entender sus límites, y eso significa medir.
No solo la precisión general, también los patrones de error, las condiciones de audio, el vocabulario, la capacidad de generalizar y los requisitos computacionales.
Un buen resultado público no equivale a un buen resultado en tu caso de uso.
Lo que se llevan otras organizaciones
Esto no vale solo para la voz clínica. Cualquier organización que incorpore IA se enfrenta a la misma tentación: elegir por el resultado de un benchmark en lugar de comprobarlo con sus propios datos y condiciones. En nuestro trabajo de consultoría y soluciones partimos del mismo principio: definir qué se va a medir, sobre qué datos y qué errores son aceptables antes de decidir la herramienta.
Es también la idea de fondo de IA especializada frente a IA genérica y de nuestro análisis sobre modelos especializados en IA clínica.
MareNostrum 5 y experimentar sobre infraestructura real
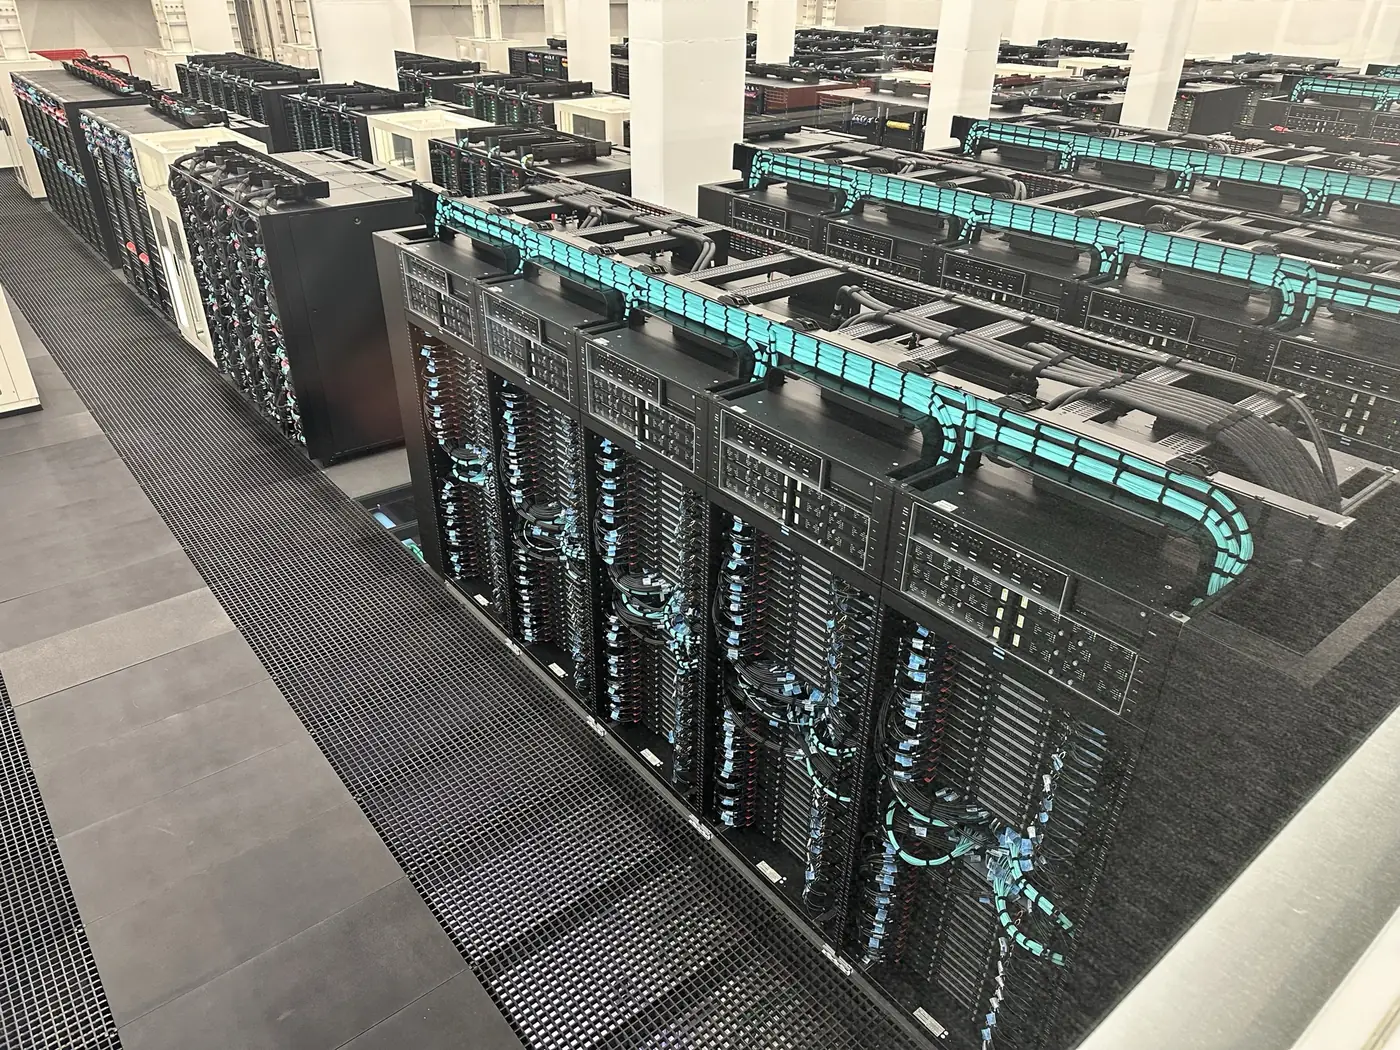
El Barcelona Supercomputing Center alberga MareNostrum 5, uno de los grandes sistemas europeos de supercomputación. Trabajar en un entorno de estas características permite investigar modelos y configuraciones que, por su demanda de computación, serían mucho más difíciles de explorar con infraestructura convencional.
Para una startup, disponer unos días de ese contexto y del acompañamiento de especialistas es una oportunidad poco habitual. Nos permitió acelerar experimentos y entender mejor cuáles merecía la pena seguir haciendo.
Lo que continúa después de Barcelona
El hackathon no cierra esta línea de trabajo: la abre. Volvemos con resultados, pero sobre todo con una imagen más precisa de las limitaciones actuales y de las preguntas que quedan por responder.
Seguiremos trabajando en reconocimiento de voz clínico en español, adaptación de modelos y evaluación de sistemas especializados dentro de nuestra línea de I+D. El objetivo no es entrenar modelos por entrenarlos, sino determinar qué arquitectura puede ofrecer resultados suficientemente consistentes para ayudar a documentar una consulta, manteniendo siempre la revisión del profesional.
Agradecimientos
Gracias al Barcelona Supercomputing Center por la oportunidad de participar y trabajar en sus instalaciones; a NVIDIA y a los mentores que nos acompañaron técnicamente; a NVIDIA Inception, por cuyo programa conocimos la convocatoria; a Do IT Now, por su participación como patrocinador; y a OpenACC y Open Hackathons por el trabajo de organización y por crear un entorno donde empresas, investigadores e ingenieros pueden experimentar sobre problemas reales.